Intelligence artificielle (IA)
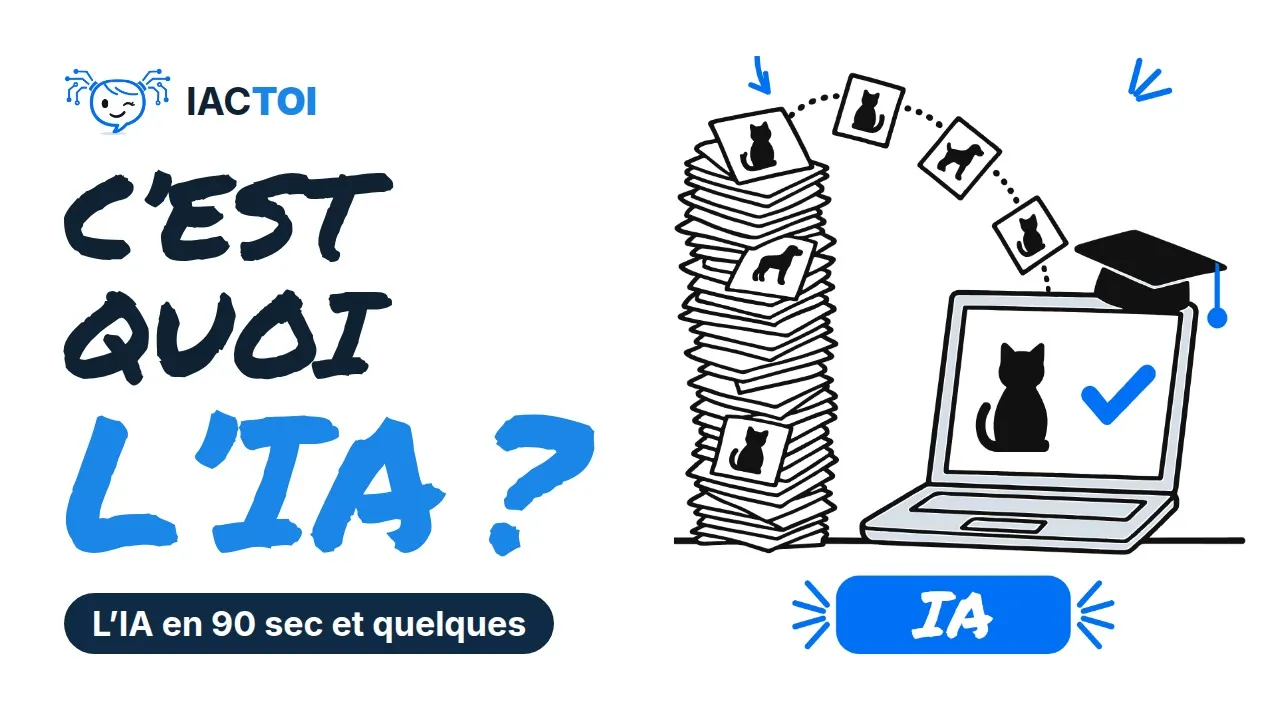
C’est quoi, une intelligence artificielle ?
Une intelligence artificielle est aujourd’hui un programme qui apprend une tâche à partir d’exemples, plutôt que de règles écrites à la main. Elle reconnaît un visage, trie des spams, prévoit une demande ou repère une pièce défectueuse sur une ligne de production. Il n’existe pas une IA unique mais une famille d’outils (image, voix, texte, prévision, robot), chacun entraîné pour sa tâche.
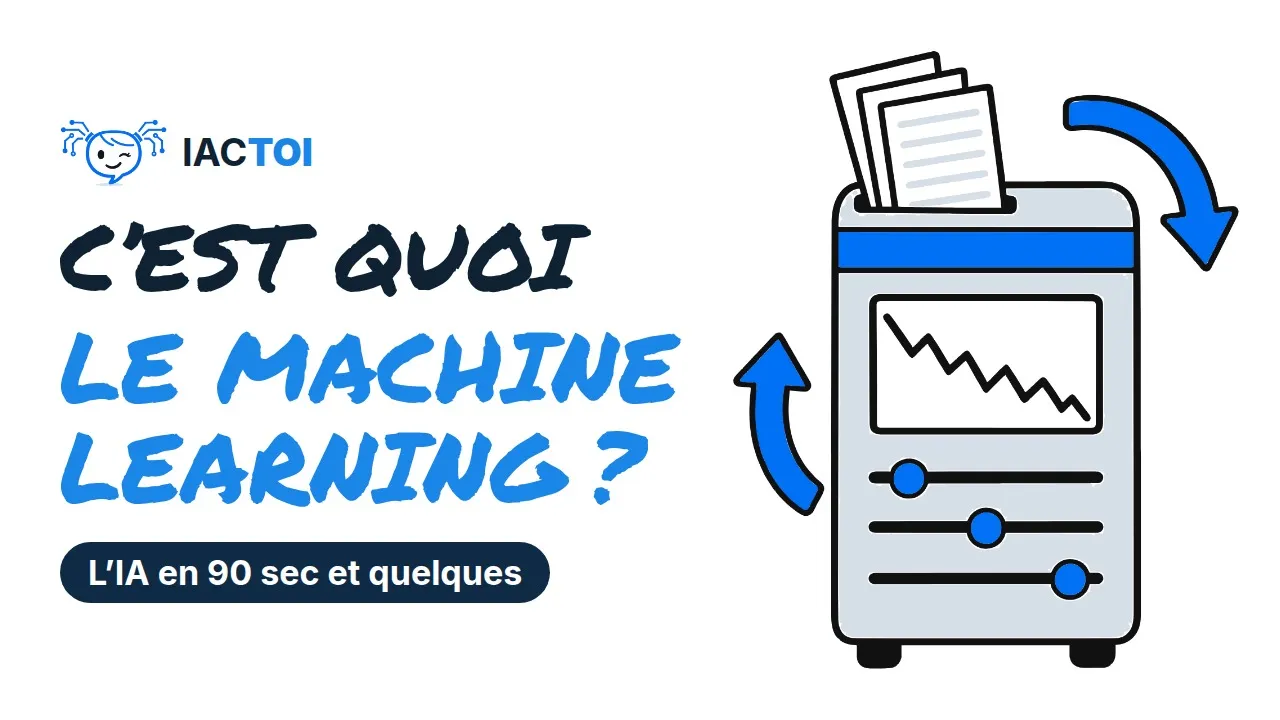
C’est quoi, le machine learning ?
Le machine learning, ou apprentissage automatique, est la branche de l’IA où un programme apprend à partir d’exemples au lieu de suivre des règles écrites à la main. Vous lui fournissez l’historique de vos commandes, il en tire une prévision des ventes du mois suivant. Le deep learning en est une sous-famille, qui s’appuie sur de grands réseaux de neurones.
Deep learning
Vidéo à venir C’est quoi, le deep learning ?
Le deep learning, ou apprentissage profond, est une branche du machine learning qui utilise des réseaux de neurones à très nombreuses couches. Il excelle là où les règles sont impossibles à écrire, comme reconnaître une image, comprendre la voix ou produire du texte. Les LLM et la plupart des IA génératives reposent sur lui, au prix de beaucoup de données et de calcul.
Réseau de neurones
Vidéo à venir C’est quoi, un réseau de neurones ?
Un réseau de neurones est un programme formé de couches de petites unités de calcul reliées entre elles, librement inspiré du cerveau. Chaque liaison porte un poids, ou paramètre, un nombre que l’entraînement ajuste peu à peu pour que le réseau donne la bonne réponse. Empiler beaucoup de couches, c’est le deep learning, lui-même une branche du machine learning.
IA générative
Vidéo à venir C’est quoi, l’IA générative ?
L’IA générative est la famille d’IA qui produit un contenu nouveau à partir d’une demande, qu’il s’agisse de texte, d’image, de son, de vidéo ou de code. Elle rédige un mail, résume un rapport ou crée un visuel produit. Les autres IA classent ou prédisent sans rien créer, par exemple trier un mail en spam ou prévoir une rupture de stock.
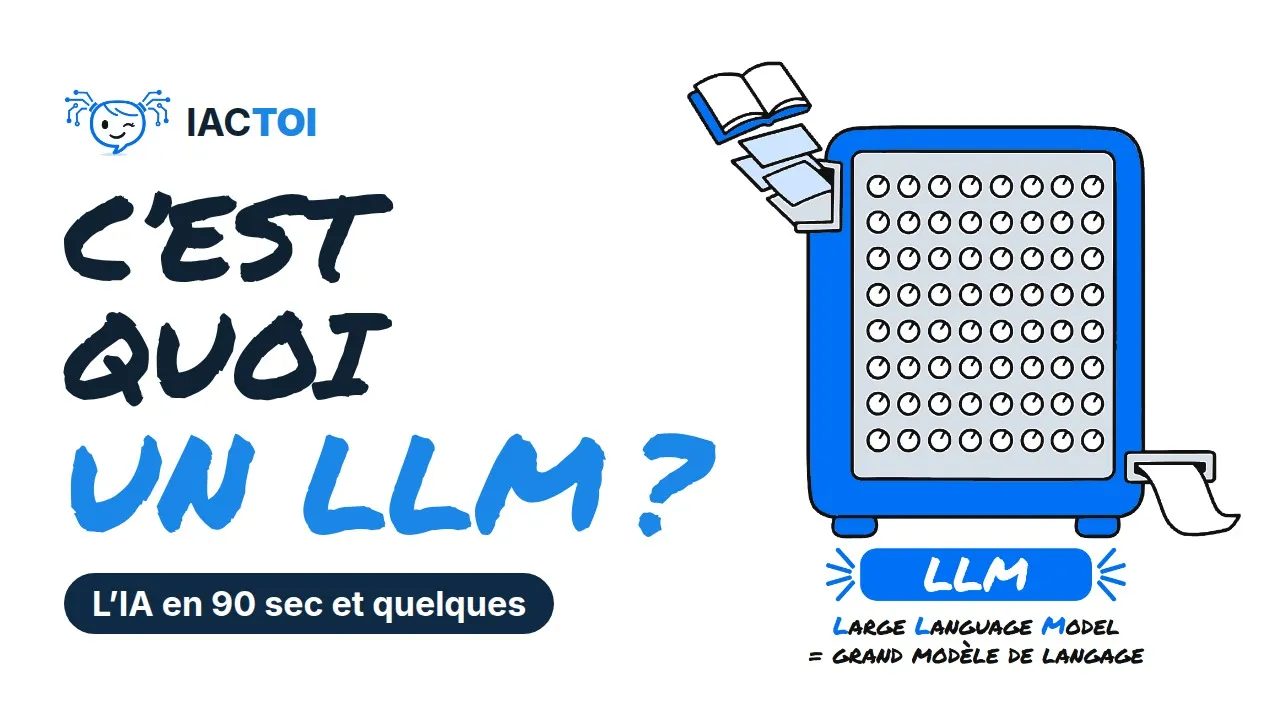
C’est quoi, un LLM ?
Un LLM, ou grand modèle de langage, est une machine qui prédit le mot le plus probable, puis le suivant, jusqu’à la réponse entière. Il a appris ces probabilités sur d’immenses quantités de textes, rangées dans des milliards de paramètres, ce qui lui permet de rédiger, résumer, traduire ou répondre. Parce qu’il vise le plausible, il peut se tromper avec assurance.
C’est quoi, un token ?
Un token est un morceau de texte, l’unité que lit un modèle de langage. Avant de lire, le modèle découpe le texte en tokens, qui peuvent être un mot entier, un bout de mot, un signe, un chiffre ou un emoji. Tout se compte en tokens : ce que le modèle peut lire d’un coup, la longueur de sa réponse et le prix facturé.
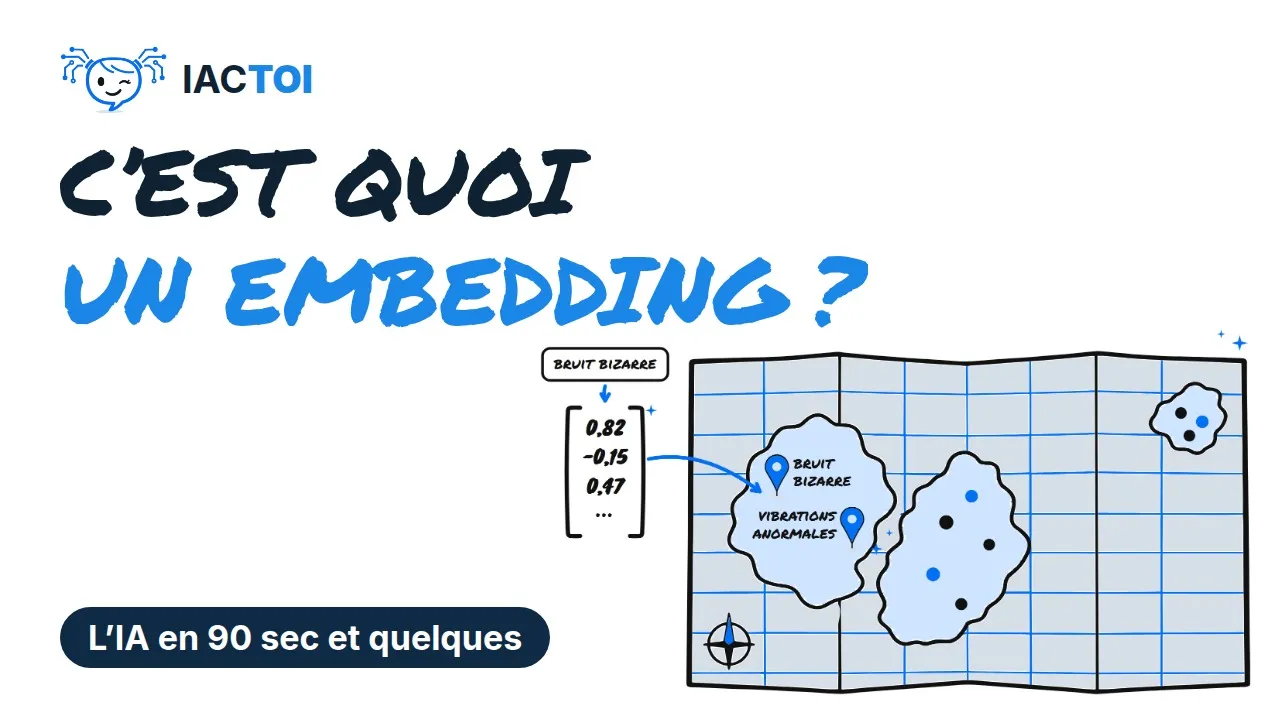
C’est quoi, un embedding ?
Un embedding est la traduction d’un texte ou d’une image en une liste de nombres, un vecteur, qui représente son sens. Deux textes qui parlent de la même chose obtiennent des vecteurs proches, même s’ils n’emploient pas les mêmes mots. C’est la matière première de la recherche sémantique, les vecteurs étant ensuite rangés dans une base de données vectorielle.
Entraînement
Vidéo à venir C’est quoi, l’entraînement d’une IA ?
L’entraînement est la phase où un modèle apprend, en ajustant ses paramètres sur d’énormes quantités d’exemples jusqu’à donner de bonnes réponses. Il a lieu avant toute utilisation et demande énormément de données, de calculs et de temps. Viennent ensuite l’inférence, quand on se sert du modèle entraîné, et parfois le fine-tuning, quand on spécialise un modèle existant.
C’est quoi, l’inférence ?
L’inférence est le moment où un modèle déjà entraîné produit un résultat à partir de nouvelles données, comme un étudiant le jour de l’examen. L’entraînement apprend, en amont ; l’inférence s’en sert, et recommence à chaque demande, qu’il s’agisse de traduire, de résumer ou de reconnaître un objet sur une photo. Chaque inférence coûte du calcul, du temps et de l’énergie.
C’est quoi, le fine-tuning ?
Le fine-tuning, ou ajustement fin, est l’opération qui spécialise un modèle déjà entraîné en poursuivant son apprentissage sur des exemples propres à un métier. On l’utilise pour imposer un ton, un format ou un vocabulaire, par exemple des réponses au style de votre service client. Il modifie le modèle lui-même, alors que le RAG lui fournit des documents au moment de répondre, sans rien réapprendre.
C’est quoi, un prompt ?
Un prompt est votre demande à l’IA, écrite en langage naturel, comme vous l’écririez à un collègue. L’IA n’a que ça, et ce que vous ne dites pas, elle le devine. Une bonne demande précise le rôle, la tâche, le contexte, le format et le ton attendus, et la réponse se relit toujours avant de servir.
C’est quoi, une fenêtre de contexte ?
La fenêtre de contexte est la quantité d’informations qu’un modèle peut traiter pour répondre, mesurée en tokens. Elle contient vos messages, ses anciennes réponses, les documents et les images, et quand la limite est atteinte, des échanges sont écartés ou résumés, ou la demande est refusée. Une fenêtre plus grande ne garantit pas que chaque détail soit bien exploité.
C’est quoi, une hallucination de l’IA ?
Une hallucination est une réponse fausse qu’une IA présente avec assurance, comme si elle était vraie, par exemple une référence, un chiffre ou une citation inventés. Elle vient du fonctionnement même d’un LLM, qui produit la suite la plus plausible et non la plus exacte. Fournir les bons documents réduit le risque sans le supprimer, et la relecture humaine reste indispensable.
C’est quoi, l’IA multimodale ?
L’IA multimodale désigne une IA capable de comprendre ou de produire plusieurs types de contenus, comme le texte, l’image, le son ou la vidéo. Vous photographiez une étiquette abîmée ou un tableau blanc, et elle en lit le texte, l’explique ou le range dans un tableau. Un modèle limité au texte, lui, ne voit ni n’entend rien.
C’est quoi, un modèle open source ?
Un modèle open source est un modèle d’IA publié pour que chacun puisse le télécharger, le faire tourner sur ses machines et l’adapter. Beaucoup de modèles dits « open source » ne publient que leurs poids, les paramètres appris, sans les données ni le code d’entraînement : on parle alors d’« open weights ». Les licences diffèrent aussi, et l’usage commercial est plus ou moins libre selon le modèle.